
Kubernetes: readiness, liveness i startup probes bez pętli restartów
Readiness, liveness i startup probes odpowiadają na różne pytania: o ruch, stan procesu i fazę startu. Zanim zmienisz manifest, zbierz stan oraz logi i oprzyj progi na pomiarach aplikacji.
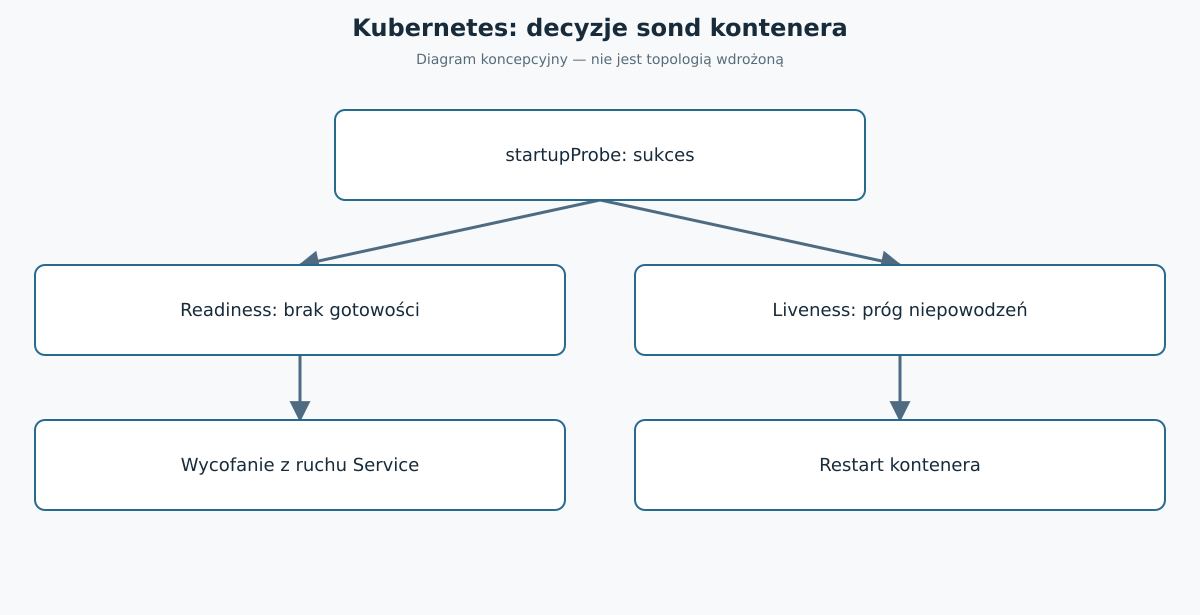
Pod restartuje się co kilka minut. Logi na pierwszy rzut oka nie pokazują niczego dramatycznego, aplikacja czasem odpowiada, a Kubernetes robi dokładnie to, o co został poproszony. To jeden z tych incydentów, w których odruchowa zmiana kilku sekund w manifeście może na chwilę uciszyć alarm, ale nie odpowie na najważniejsze pytanie: czy problem dotyczy startu aplikacji, obsługi ruchu, czy procesu, który naprawdę utknął?
Trzy sondy Kubernetes nie są trzema wariantami tego samego testu zdrowia. Każda podejmuje inną decyzję operacyjną. startupProbe wyznacza koniec inicjalizacji. readinessProbe mówi, czy Pod powinien teraz otrzymywać ruch z pasujących Services. livenessProbe ma rozpoznać stan, z którego proces nie wróci bez restartu. Pomieszanie tych ról jest prostą drogą do sytuacji, w której chwilowo niedostępna zależność uruchamia serię restartów i pogarsza awarię zamiast ją ograniczać.
Trzy pytania, trzy różne konsekwencje
Jeśli skonfigurowano startupProbe, kubelet nie wykonuje kontroli readiness ani liveness, dopóki sonda startowa nie zakończy się sukcesem. Daje to wolno uruchamiającej się aplikacji osobne okno na inicjalizację, bez sztucznego rozluźniania późniejszych kontroli. Przekroczenie progu niepowodzeń startup probe kończy kontener zgodnie z restartPolicy. Ta sonda powinna więc opisywać fazę startu — nie zastępować readiness po uruchomieniu ani pełnić roli okresowego testu działania.
Readiness odpowiada na bardziej codzienne pytanie: czy ta instancja może przyjąć normalny ruch? Niepowodzenie wycofuje Pod z routingu pasujących Services, ale samo w sobie nie restartuje kontenera. Proces może działać, zbierać dane, dogrzewać cache albo czekać na stan, w którym bezpiecznie obsłuży żądania. To nie musi oznaczać awarii wymagającej zniszczenia procesu. Właśnie dlatego readiness dobrze nadaje się do ochrony ruchu podczas inicjalizacji albo przejściowego braku gotowości.
Liveness ma znacznie cięższy skutek. Po sukcesie startup probe działa niezależnie od readiness, a po przekroczeniu failureThreshold kubelet restartuje konkretny kontener. Ma to sens przy zakleszczeniu lub innym stanie procesu, którego aplikacja sama nie potrafi naprawić. Nie naprawi natomiast zewnętrznej bazy danych i nie zrestartuje całego klastra. Jeśli endpoint liveness zależy od chwilowo przeciążonej usługi zewnętrznej, restart lokalnego procesu może tylko dołożyć koszt rozruchu w najgorszym momencie.
Dobra konfiguracja zaczyna się zatem od semantyki endpointów, a dopiero później przechodzi do liczb. Startup opisuje zakończenie inicjalizacji, readiness — możliwość przyjmowania ruchu, a liveness — trwałą niezdolność procesu do odzyskania działania. Jedna odpowiedź „OK” nie powinna mechanicznie sterować wszystkimi trzema decyzjami.
Najpierw obserwacja, potem manifest
Zanim zmienisz progi, zbierz stan Poda oraz logi. kubectl describe pod pokaże stany kontenerów, Last State i zdarzenia. Sam CrashLoopBackOff nie dowodzi jeszcze, że winna jest liveness; mówi tylko, że kontener wszedł w pętlę uruchamiania. Przyczynę trzeba odtworzyć z sekwencji zdarzeń oraz logów bieżącej i poprzedniej instancji.
Poniższe polecenia wyłącznie odczytują dane. NAMESPACE, POD i CONTAINER są placeholderami, które trzeba świadomie zastąpić. Poleceń nie wykonano na klastrze użytkownika. Opcja --previous ma sens tylko wtedy, gdy istnieje poprzednia instancja wskazanego kontenera. Jeśli jej nie ma, to polecenie nie dostarczy logu poprzedniego uruchomienia.
kubectl -n NAMESPACE describe pod POD
kubectl -n NAMESPACE logs POD -c CONTAINER --tail=100
kubectl -n NAMESPACE logs POD -c CONTAINER --previous --tail=100
Czy readiness zawodzi bez restartów? Wtedy główną konsekwencją jest wycofanie z ruchu, więc szukaj przyczyny w warunku gotowości, kolejności inicjalizacji i stanie aplikacji. Czy po serii niepowodzeń liveness rośnie licznik restartów? Sprawdź, czy test rzeczywiście opisuje stan nieodwracalny dla procesu, czy jedynie kłopot z zależnością. A może objaw pojawia się jeszcze przed sukcesem startup probe? W takim przypadku osobno oceń czas rozruchu i to, co aplikacja robi podczas inicjalizacji.
Pomocne jest ułożenie osi czasu: sukces lub kolejne porażki startup probe, zmiany readiness, zdarzenia restartu, a obok nich logi. Taki obraz zwykle mówi więcej niż pojedynczy komunikat. Pozwala też uniknąć popularnej diagnozy „health check nie działa”, która wrzuca trzy mechanizmy i trzy różne skutki do jednego worka.
Progi muszą wynikać z zachowania aplikacji
periodSeconds określa częstotliwość kontroli, timeoutSeconds ogranicza czas jednej próby, a failureThreshold mówi, ile kolejnych niepowodzeń prowadzi do uznania sondy za nieskuteczną. Dla sond HTTP sukcesem są kody od 200 do 399. Te definicje są uniwersalne; właściwe wartości już nie.
Nie znamy czasów startu tej aplikacji, jej zależności ani zachowania pod normalnym obciążeniem, dlatego uczciwy poradnik nie poda gotowego kompletu produkcyjnych timeoutów. Najpierw zmierz typowy i skrajny czas inicjalizacji oraz odpowiedzi endpointu. Sprawdź, czy krótkie spowolnienie jest normalnym zjawiskiem, czy sygnałem trwałego zakleszczenia. Dopiero wtedy ustaw okresy i progi tak, by tolerowały oczekiwane wahania, ale reagowały na rzeczywisty problem.
Przed edycją manifestu dobrze odpowiedzieć sobie na kilka konkretnych pytań. Która faza zawodzi: start, gotowość do ruchu czy żywotność procesu? Czy startup probe zdążyła osiągnąć sukces? Co pokazują Last State, zdarzenia i log poprzedniej instancji? Czy liveness bada własny stan procesu, czy dostępność usługi, której restart kontenera nie naprawi? I wreszcie: czy planowana zmiana ma mierzalny cel oraz sposób obserwacji skutków?
Wyobraźmy sobie aplikację, w której wszystkie endpointy zdrowotne zwracają tę samą odpowiedź, choć kubelet używa ich do różnych decyzji. Chwilowy brak odpowiedzi zależności może uzasadniać odsunięcie instancji od ruchu. Nie musi jednak oznaczać, że sam proces utracił zdolność działania i powinien zostać uruchomiony ponownie. Podobnie długi start nie jest jeszcze problemem liveness, jeśli aplikacja nadal wykonuje oczekiwaną inicjalizację. Rozdzielenie tych stanów w kodzie aplikacji i manifeście daje operatorowi czytelniejszy obraz niż jeden zbiorczy endpoint „health”.
W takim scenariuszu warto też obserwować skutki w skali całego workloadu. Kilka replik reagujących tak samo na niedostępność wspólnej zależności może wejść w podobny cykl restartów. Readiness nadal odsuwa niegotowy Pod od normalnego ruchu bez restartowania jego kontenera. To, czy użytkownicy zachowają ciągłość obsługi, zależy już od gotowości pozostałych replik i architektury aplikacji, a nie od samego działania sondy. To kolejny powód, by nie oceniać parametrów w oderwaniu od obserwowanego zachowania całego workloadu. Zmiana sondy powinna być hipotezą opartą na tych danych, nie sposobem na uciszenie objawu. Po wdrożeniu trzeba obserwować zarówno routing, jak i restarty oraz czas startu. Jeśli poprawa jednego wskaźnika odbywa się kosztem drugiego, konfiguracja nadal nie oddaje właściwie zachowania aplikacji.
Ten schemat nie zastępuje wiedzy o konkretnym workloadzie i nie udaje testu na cudzym klastrze. Porządkuje jednak decyzje, od których zależy przebieg incydentu: readiness chroni ruch, liveness może zniszczyć i odtworzyć proces, a startup probe daje inicjalizacji osobną przestrzeń. Kiedy te role są czytelne, diagnostyka przestaje być polowaniem na magiczną wartość failureThreshold.