Hardening Oracle Linux 9 pod Kubernetes: praktyczne zabezpieczenia, walidacja i pułapki
Praktyczne zabezpieczenia Oracle Linux 9 pod Kubernetes: walidacja, pułapki i doświadczenia z wdrożenia.
Hardening węzła jako kontrolowana zmiana
Hardening węzła Kubernetes nie był jednorazowym zastosowaniem profilu, lecz sekwencją małych zmian z osobnymi punktami decyzyjnymi. Szczególnie dotyczyło to SSH, PAM, SELinux, mountów i firewalla, gdzie poprawna składnia nie przesądza jeszcze o dostępności hosta ani zdrowiu klastra.
Przed edycją kluczowych plików tworzono kopie, ale przywracanie dotyczyło konkretnego zmienionego pliku, nie całego pakietu hardeningu. Dla SSH dodatkową bramką były sshd -t oraz logowanie w nowej sesji przed zamknięciem starej. To punkt odniesienia dla wąskiego rollbacku: przywrócenia konkretnego pliku i ponownej walidacji.
Poniższy wzorzec pokazuje samą kopię, nie pełną weryfikację backupu. Najpierw wybierz nieużywaną nazwę sesji; pola w nawiasach wymagają lokalnego uzupełnienia:
session=<UNIKALNA_NAZWA_SESJI>
install -d -m 0700 "/root/hardening-backup/$session"
cp -a -- <PLIK> "/root/hardening-backup/$session/<NAZWA_ZMIANY>.before"
cp -a zachowuje możliwie wiele atrybutów, ale może przemilczeć niepowodzenie zachowania części z nich. Kod zakończenia ani ogólny odczyt stat nie wystarczają do weryfikacji xattr i SELinux. Przy krytycznych plikach niezależnie sprawdź wymagane metadane kopii i kontekst. Nazwa sesji musi być unikalna, aby nie nadpisać wcześniejszej kopii; sam sufiks .before nie daje wersjonowania. Nie przywracaj symlinka o nieustalonej tożsamości.
Restart węzła pozostawał osobnym etapem operacyjnym. Przed nim trzeba uwzględnić graceful shutdown, workloady stateful, storage oraz topologię klastra; poprawność konfiguracji hosta nie oznacza jeszcze, że dowolny moment jest bezpieczny dla restartu.
Mounty: restrykcje, zgodność workloadu i test noexec
W tym wdrożeniu /tmp i /dev/shm otrzymały nosuid,nodev,noexec, /home — nosuid,nodev, natomiast /var/tmp i /var/log — nosuid,nodev,noexec. Brak noexec na /home był świadomą decyzją zgodnościową, a nie niedokończonym hardeningiem. noexec ogranicza bezpośrednie wykonywanie plików, nodev interpretowanie plików urządzeń, a nosuid działanie bitów setuid i setgid. Żadna z tych opcji nie zastępuje analizy workloadu; w szczególności noexec nie blokuje całkowicie uruchamiania kodu przekazanego interpreterowi.
Najpierw sprawdzano rzeczywisty filesystem i aktywne opcje, zamiast wnioskować tylko z deklaracji w fstab:
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target /tmp
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target /dev/shm
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target /home
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target /var/tmp
findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target /var/log
findmnt --verify
findmnt --target może wskazać mount rodzica, dlatego pole TARGET trzeba porównać z oczekiwaną granicą. Sam odczyt nie dowodzi zgodności z projektem ani z fstab; znaczenie ma status każdej komendy oraz porównanie wymaganych opcji. Nie jest konieczna osobna partycja, jeśli istnieje właściwie zaprojektowany mount zapewniający żądane granice.
W case bezpośrednie uruchomienie pliku z /tmp kończyło się komunikatem Permission denied, a findmnt --verify nie wykazywał błędów. Powtarzalny test można zbudować z mktemp, ale niezerowy status sam w sobie nie dowodzi działania noexec:
(
# Przed wykonaniem potwierdź aktywny mount /tmp i opcję noexec.
set -e
test_file=$(mktemp /tmp/noexec-check.XXXXXX) || exit 1
cleanup() { rm -f -- "$test_file"; }
trap cleanup EXIT
printf '#!/bin/sh\nexit 0\n' >"$test_file" || exit 1
chmod 0700 "$test_file" || exit 1
if "$test_file"; then
  test_status=0
else
  test_status=$?
fi
printf 'direct exec status: %s\n' "$test_status"
)
Przed próbą trzeba potwierdzić mount i noexec, a następnie powodzenie zapisu oraz chmod. Oczekiwany błąd jest przechwytywany w if, także przy errexit. Stderr pozostaje widoczny w terminalu — oceń go razem ze statusem. Osobna powłoka i pułapka EXIT ograniczają cleanup do tego testu, również po błędzie zapisu lub chmod. Błąd może pochodzić z innej przyczyny, a wywołanie sh "$test_file" bada interpreter, nie bezpośredni exec. Taki test jest wzorcem technicznym; nie jest historyczną komendą z wdrożenia.
SSH, sudo i sesje administracyjne bez odcięcia dostępu
Dostęp SSH zmieniano z aktywną sesją ratunkową. Ustawiono PermitRootLogin no, a logowanie ograniczono przez AllowGroups sshusers. Ręczną listę MAC zastąpiono system-wide crypto policy Oracle Linux 9; nie zaostrzano kryptografii szerzej bez odrębnego wymagania i testów kompatybilności.
Sekwencja obejmowała kontrolę składni, inspekcję konfiguracji efektywnej i reload:
sshd -t
sshd -T
systemctl reload sshd
Po reloadzie otwierano nową sesję uprawnionego użytkownika i dopiero po jej sprawdzeniu zamykano starą. Jeżeli konfiguracja zawiera Match, można dodatkowo ocenić konkretny kontekst:
sshd -T -C user=<USER>,host=<HOST>,addr=<CLIENT_IP>Parametry muszą odpowiadać badanej regule; host oznacza rozstrzygniętą nazwę hosta źródłowego. Ta możliwość nie była przedstawiana jako wykonany krok case.
Dla sudo ustawiono Defaults use_pty. Dostęp przez su ograniczono dedykowaną pustą grupą z użyciem pam_rootok i pam_wheel. Globalne sesje powłoki otrzymały TMOUT=900, oznaczony jako readonly i wyeksportowany. Opis case potwierdza te ustawienia, nie wspólną procedurę testowania TMOUT, sudo i su. Poniższe polecenia to zalecane kontrole składni i lokalizacji wpisów, a nie zapis ich wykonania w case ani pełny audyt efektywnej polityki:
visudo -cf /etc/sudoers
grep -R '^[[:space:]]*Defaults.*use_pty' /etc/sudoers /etc/sudoers.d
grep -n 'pam_\(rootok\|wheel\)\.so' /etc/pam.d/su
grep -R '^[[:space:]]*TMOUT=' /etc/profile /etc/profile.d
visudo -c sprawdza składnię, natomiast grep jedynie odnajduje tekst. Komentarze, pliki dołączane, kolejność i inne formy przypisania mogą zmieniać wynik efektywny, więc taki zestaw nie jest kompletnym audytem. Jako odrębne zalecenie sprawdź zachowanie TMOUT, sudo i su w nowej sesji; znalezienie wpisu nie potwierdza readonly ani eksportu. Nazwę i członkostwo grupy ograniczającej su należy odczytać z rzeczywistej konfiguracji — nie wynikają z samej obecności modułu PAM.
PAM i ważność haseł: aktywny profil jest częścią konfiguracji
Na hostach aktywny był niestandardowy profil authselect. Włączono funkcje with-faillock, with-pwhistory i without-nullok. Parametry przyjęte w przykładzie to deny=5 i unlock_time=900 dla faillock, remember=24, enforce_for_root i use_authtok dla historii haseł oraz minlen=14, minclass=4, maxrepeat=3, maxsequence=3 dla jakości. Aging ustawiono na PASS_MAX_DAYS=365, PASS_MIN_DAYS=1 i PASS_WARN_AGE=7.
# /etc/security/faillock.conf
deny = 5
unlock_time = 900

# /etc/security/pwhistory.conf
remember = 24
enforce_for_root

# /etc/security/pwquality.conf
minlen = 14
minclass = 4
maxrepeat = 3
maxsequence = 3

# /etc/login.defs
PASS_MAX_DAYS 365
PASS_MIN_DAYS 1
PASS_WARN_AGE 7
Pliki faillock.conf, pwhistory.conf i pwquality.conf konfigurują odpowiednie moduły, ale ich obsługa zależy od wersji pakietów i aktywnego stosu PAM. pwhistory.conf nie jest rozwiązaniem uniwersalnym dla wszystkich wczesnych wydań 9.x, opcje stosu mogą nadpisywać plik, a sam zapis nie aktywuje modułu. Lokalne strony podręcznika są tu źródłem rozstrzygającym. enforce_for_root powinno być traktowane jako jawna opcja techniczna; faktem case jest jego użycie w przykładzie pwhistory, nie automatycznie w każdym module.
Rozpoznanie stanu zaczyna się od poleceń tylko odczytujących:
authselect current
authselect check
authselect check kontroluje spójność konfiguracji. Funkcje można włączać przez authselect enable-feature, ale jest to osobna modyfikacja: najpierw wykonaj kopię, potwierdź dostępność funkcji i ich zgodność z aktywnym profilem. Gdy funkcja jest niedostępna lub profil ma konflikt, zatrzymaj zmianę. Wymienione wcześniej trzy funkcje opisują wdrożenie, nie uniwersalny zestaw do skopiowania.
Nie należy zakładać dostępności każdej funkcji w dowolnym profilu custom ani omijać konfliktów przez --force. Poniższe grep jedynie lokalizują zapisane wartości; nie rozstrzygają, czy aktywny stos PAM ich używa. chage służy osobnej kontroli wskazanego konta:
grep -R '^[[:space:]]*\(deny\|unlock_time\|remember\|minlen\|minclass\|maxrepeat\|maxsequence\)' /etc/security
grep -E '^(PASS_MAX_DAYS|PASS_MIN_DAYS|PASS_WARN_AGE)' /etc/login.defs
chage -l <KONTO_TESTOWE>
Zmiana trzech wartości aging w login.defs wpływa na tworzenie kont, lecz nie aktualizuje istniejących użytkowników; te wymagają osobnego przeglądu. W opisywanym wdrożeniu przed ustawieniem max=365 dla roota odświeżono hasło, aby nie wywołać natychmiastowego wygaśnięcia.
SELinux Enforcing najpierw w runtime, potem na stałe
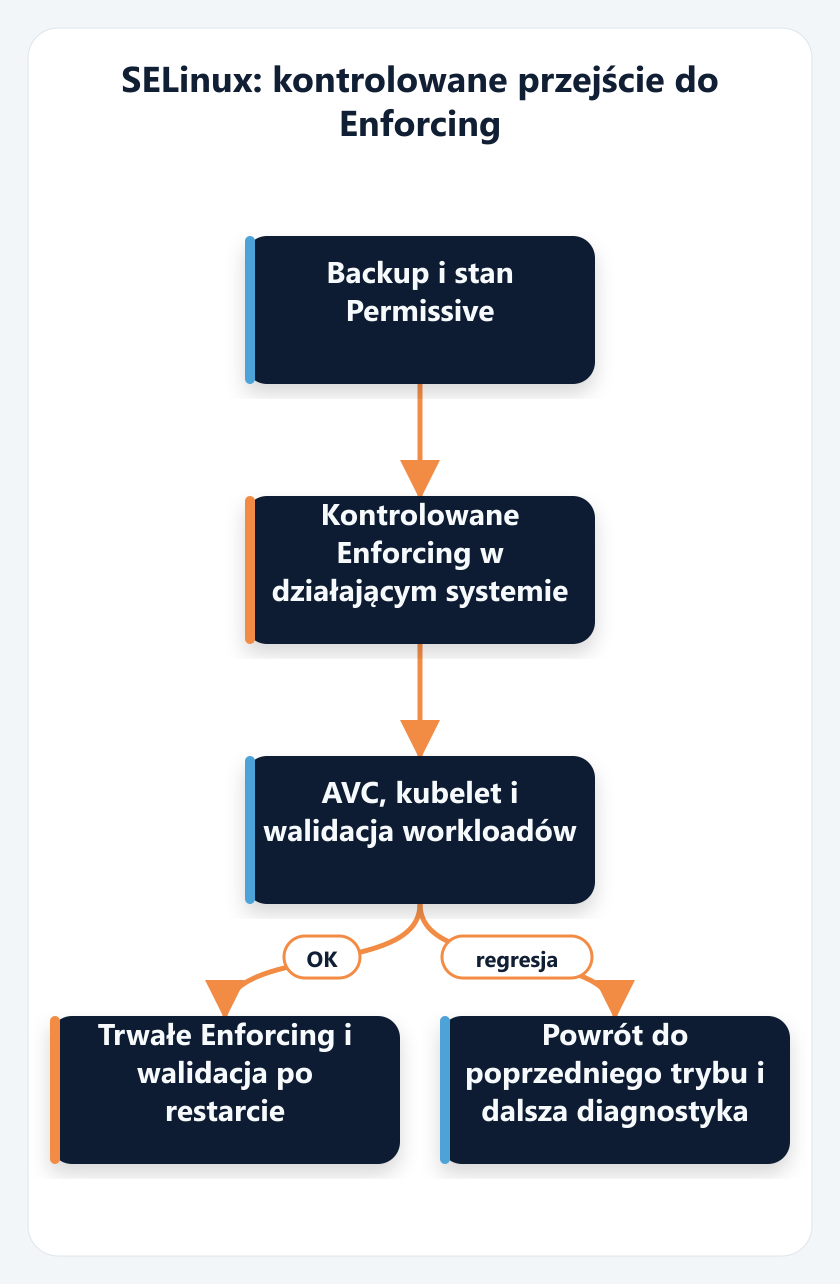
Hosty zaczynały w trybie SELinux Permissive. Zamiast od razu utrwalać Enforcing, najpierw przełączono runtime i obserwowano rzeczywisty ruch:
setenforce 1
getenforce
ausearch -m AVC,USER_AVC -ts recent -i
systemctl is-active kubelet containerd
kubectl get nodes
kubectl get pods -A
Przy aktywnym Enforcing walidowano kubelet, workloady oraz workload korzystający z hostPath. Analiza obejmowała zdarzenia AVC i USER_AVC, a nie tylko status usług.
W tym wdrożeniu po obserwacji bez AVC i testach komponentów utrwalono SELINUX=enforcing. To wynik opisanych obserwacji, nie gwarancja pokrycia wszystkich scenariuszy. Po rebootach hosty nadal działały w Enforcing. Rozdzielenie zmiany runtime od utrwalenia pozostawia prostszy punkt odwrotu: jeśli regresja pojawia się przed edycją konfiguracji trwałej, nie trzeba jednocześnie odkręcać dwóch warstw stanu.
Firewall: nasłuchujące procesy, test reguły i utrwalenie
Szerokie reguły portów usuwano dopiero po potwierdzeniu, że nie odpowiadają aktywnym listenerom. Punktem wyjścia były procesy nasłuchujące, aktywne strefy i bieżąca zawartość wybranej strefy:
ss -lntup
firewall-cmd --get-active-zones
firewall-cmd --zone=<STREFA> --list-all
Nową regułę dodawano najpierw do runtime, przeprowadzano test ruchu i dopiero potem utrwalano ją jako permanent. Uniknięto niepotrzebnego firewall-cmd --reload podczas pracy klastra. To opis kolejności przyjętej w tym wdrożeniu.
Mechanizm firewall-cmd --zone=... --add-rich-rule=... wymaga konkretnej, zatwierdzonej reguły. Przed zmianą zapisz dokładny tekst reguły i strefę; rollback polega na usunięciu właśnie tej reguły z tej samej strefy runtime, nie na przeładowaniu całego firewalla.
Bez --permanent polecenie zmienia runtime. Ten opis nie jest gotową regułą ani rekonstrukcją zanonimizowanych adresów. Składnię, strefę, zakres źródłowy i oczekiwany przepływ trzeba zatwierdzić przed użyciem; nie należy na tej podstawie dopisywać rzekomej reguły antyspoofingowej. W razie regresji usuwa się dokładnie tę samą regułę runtime i ponawia test. Dopiero zaakceptowany rezultat uzasadnia osobny krok permanent.
AIDE na węźle Kubernetes: co monitorować, a co wykluczyć
Pierwszy zakres AIDE objął setki gigabajtów dynamicznych danych. Taki baseline prowadziłby do ciężkich skanów i fałszywych alarmów, więc kryterium sukcesu zmieniono z „objąć jak najwięcej” na „objąć stabilne elementy o wartości konfiguracyjnej”. Wyłączono runtime i snapshoty, dynamiczny stan kubeleta, stan CNI oraz logi runtime. Pod kontrolą pozostały /etc, katalogi binariów, /boot, /etc/kubernetes, /etc/containerd i /etc/cni. Dodano również ochronę sześciu narzędzi audytowych; aide --config-check kończył się RC=0.
Zakres trzeba budować z rzeczywistych mountów i rozmiarów, bez automatycznego włączania danych aplikacyjnych:
findmnt
aide --config-check
Reguły AIDE są wyrażeniami regularnymi. Literalną ścieżkę należy poprawnie zapisać z uwzględnieniem znaków specjalnych regex, rozróżnić katalog od potomków — przykładowo granicą (/|$) — i sprawdzić zachowanie lokalnej wersji. NORMAL musi istnieć lokalnie, jeśli chcesz użyć tej grupy atrybutów. Stabilna konfiguracja kubeleta i binaria CNI wymagają odrębnego rozpatrzenia od dynamicznych poddrzew. Nie ma tu gotowego zestawu regexów: lokalne ścieżki i rzeczywiste dopasowania trzeba zweryfikować przed zmianą zakresu.
Trzeba przejrzeć faktyczne dopasowania. Zbyt szeroka reguła negatywna może wyłączyć również stabilne pliki, dlatego nie należy odrzucać całego rodzica bez analizy potomków.
Po optymalizacji baseline miał kilka megabajtów, inicjalizacja trwała dziesiątki sekund, a check kończył się RC=0. Według zapisu case regularny check uruchamiano z crona roota o 05:00 UTC. To informacja o tym wdrożeniu, nie wynik walidacji harmonogramu na innym hoście. Przed zastąpieniem istniejącej bazy zachowaj wersjonowaną kopię bazy i poprzedniej konfiguracji przez cp -a w nieużywanym, prywatnym katalogu i sprawdź jej integralność. Pierwsza inicjalizacja bez aktywnej bazy jest innym przypadkiem. Kopia na tym samym hoście nie jest niezależnym zaufanym repozytorium.
aide --init tworzy bazę kandydującą. Kandydat może zostać aktywowany dopiero po sukcesie inicjalizacji oraz sprawdzeniu rzeczywistych ścieżek, właściciela, wymaganych metadanych i kontekstu SELinux. Po błędzie init nie aktywuj kandydata. Sposób aktywacji potwierdź w dokumentacji lokalnej wersji Oracle Linux/AIDE — ten artykuł nie podaje uniwersalnego skryptu. Samo kopiowanie z narzuconym trybem nie gwarantuje zachowania xattr, atomowości ani odtworzenia wszystkich metadanych; uwzględnij też uprawnienia procesu czytającego bazę.
Nouser przy hostPath: najpierw tożsamość kontenera
Wynik nouser przy danych udostępnianych przez hostPath nie został potraktowany jako dowód osierocenia. Poniższy publiczny wzorzec diagnostyczny pozwala odczytać numery UID/GID, mapowanie NSS i tożsamość nowego polecenia w kontenerze. Nie jest zapisem komend wykonanych w case:
find <PERSISTENT_DATA_PATH> -xdev \( -nouser -o -nogroup \) -printf '%U:%G %p\n'
kubectl -n <NAMESPACE> exec <POD> -c <CONTAINER> -- id
getent passwd <UID>
getent group <GID>
find wskazuje brak mapowania właściciela lub grupy w warunkach tego odczytu, a getent odpytuje NSS; wyniku nie należy traktować jako niezależnego od tego mapowania. Brak wpisu na hoście nie oznacza automatycznie, że dane są porzucone. kubectl exec ... -- id uruchamia nowy proces, wymaga autoryzacji i pokazuje tożsamość tego polecenia, niekoniecznie już działającego procesu aplikacji. Samo id nie zmienia właściciela plików. User namespaces, ACL i grupy dodatkowe wymagają oddzielnej analizy; nie można automatycznie żądać równości UID tylko na podstawie jednego odczytu.
Dla aktywnych danych utworzono lokalne mapowanie do konta z /sbin/nologin, nie zmieniając właściciela inode. W analogicznym przypadku celowo uniknięto chown, ponieważ masowa zmiana właściciela danych trwałych mogłaby uszkodzić działanie aplikacji. To opis rozwiązania zastosowanego dla zidentyfikowanych danych, nie ogólna recepta na każdy wynik nouser.
Wyjątek ip_forward i zdrowie sieci klastra
net.ipv4.ip_forward=1 pozostawiono jako udokumentowany wyjątek wymagany przez Kubernetes i Calico. Mechaniczne wyłączenie parametru mogłoby zerwać networking klastra, dlatego nie traktowano ogólnej rekomendacji hostowej jako nadrzędnej wobec architektury węzła.
Parametr należał do końcowych kontroli wykonywanych razem ze stanem klastra:
sysctl net.ipv4.ip_forward
kubectl get nodes
kubectl get pods -A
Sam odczyt sysctl potwierdza stan jądra, ale nie zdrowie sieci. Stan węzłów i podów jest osobnym wynikiem kontroli; te odczyty nie zastępują testu działania workloadów.
Rotowane logi: korekta wąska zamiast globalnego UMask
Skan wykazał rotowane logi Kubernetes z trybem 0644. Nie zmieniono globalnego UMask kubeleta z 0022 na 0027, ponieważ wpłynęłoby to również na inne pliki tworzone przez usługę. Zamiast tego fixer obejmował wyłącznie pliki *.gz z nadmiernymi bitami uprawnień w kontrolowanym drzewie logów i ustawiał im tryb 0640. To zakres opisany w case; nie zastępujemy go uproszczonym selektorem pojedynczego trybu. Fixer działał jako systemd oneshot, wywoływany timerem co minutę z Persistent=true. Nie odtwarzamy tu jednostek z case ani gotowej konfiguracji do instalacji.
Type=oneshot i ExecStart opisują zadanie, a OnBootSec oraz OnUnitActiveSec harmonogram monotoniczny. Timer nie gwarantuje uruchomienia dokładnie co minutę; wpływ mają między innymi AccuracySec i stan usługi. Parametry te opisują mechanizm; lokalna wersja systemd, ścieżki, argumenty i uprawnienia wymagają sprawdzenia.
Przed wdrożeniem własnego wariantu można użyć bash -n i systemd-analyze verify. Pierwsze polecenie sprawdza składnię skryptu bez wykonania, drugie może wykryć nieznane dyrektywy i brakujące zależności jednostek. Nie dowodzą one bezpieczeństwa skryptu ani poprawności workloadu i nie są dowodem wykonania w case.
Walidacja bieżąca, po restarcie i wycofanie zmian
Walidacja bieżąca obejmowała stan SELinux, SSH, usług systemowych, węzłów, podów i zdarzeń AVC. Po pełnym reboocie utrzymały się SELinux Enforcing, opcje mountów, SSH, PAM, firewall oraz usługi. Ponowna kontrola nie ograniczała się do pytania, czy host wrócił: sprawdzano również aktywne mounty i zdarzenia od bieżącego bootu.
getenforce
for target in /tmp /dev/shm /home /var/tmp /var/log; do
  findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS --target "$target" || exit 1
done
sshd -t
systemctl is-active firewalld sshd kubelet containerd
kubectl get nodes
kubectl get pods -A
ausearch -m AVC,USER_AVC -ts boot -i
Dla każdego wyniku findmnt trzeba sprawdzić, czy TARGET jest oczekiwanym mountem, czy tylko rodzicem, a następnie porównać zestaw opcji z planem. Status polecenia także jest częścią wyniku. Lista podów wymaga interpretacji oraz osobnego sprawdzenia działania workloadów; same statusy Running i Completed nie są pełnym testem ich zdrowia.
Restart musi zostać zaplanowany z uwzględnieniem graceful shutdown, workloadów stateful, storage i topologii. Dopiero wtedy wynik po boot może być traktowany jako test trwałości konfiguracji, a nie niekontrolowane zakłócenie.
Rollback pozostaje wąski: przywraca się konkretny plik i uruchamia właściwy dla niego walidator, na przykład sshd -t dla konfiguracji SSH albo authselect check dla profilu. Następnie ponawia się kontrolę systemu, kubeleta, klastra i workloadów. Nie należy cofać całego zestawu zmian, jeśli regresję można przypisać jednej konfiguracji.
Checklista wdrożeniowa
Poniższa checklista zbiera opisane wcześniej kroki. Służy do sprawdzenia własnej zmiany, nie deklaruje wykonania wszystkich testów w case.
- Zachować wersjonowaną kopię zmienianego pliku i ustalić sposób jego przywrócenia.
- Sprawdzić metadane kopii istotne dla danego pliku, w tym kontekst SELinux/xattr tam, gdzie ma to znaczenie.
- Po zmianie uruchomić właściwy walidator konfiguracji i sprawdzić stan systemu.
- Sprawdzić kubelet, runtime kontenerowy, węzły, pody i działanie workloadów.
- Po zaplanowanym restarcie porównać aktywne mounty i ich opcje z planem.
- Po przywróceniu konkretnego pliku ponowić walidację konfiguracji oraz kontrolę systemu i klastra.